
ECC如何定位错误位?
数据错了,ECC凭什么知道哪一位错了?
上一篇我们讲到,NAND Flash中的数据,并不能保证永远是正确的,所以SSD需要通过ECC来增加冗余,让数据发生一定程度的错误之后,仍然有希望可以被恢复。
那多出来的这些信息(冗余),到底怎么发挥作用呢?
如果有一段数据读出来以后,其中有一个bit发生了翻转。ECC首先要做的就是发现数据有问题,还要进一步判断:到底是哪一个位错了?
要回答这个问题,我们要从最基本的校验规则说起。
最简单的校验:奇偶校验
在二进制数据中,有一种非常简单的校验方式叫奇偶校验(Parity Check)。
它的规则很简单:规定一组数据中“1” 的数量必须满足某种要求。
比如,我们规定:一组数据中, 1的数量必须是偶数。
假设原始的数据是这样的: 10110010 其中有4个1, 满足我们的要求。
如果读取之后变成了这样:10100010 这时只有3个1了,校验失败。
我们于是可以知道:这组数据发生了错误。
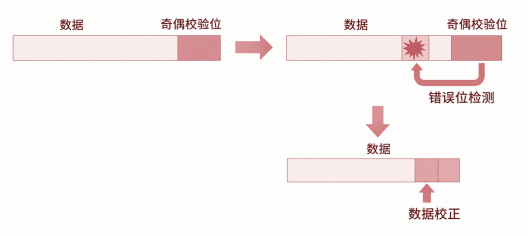
奇偶校验的价值就在这里, 它通过一个简单的规则来检查数据是否发生过变化。
但很快我们会又发现问题:它只能告诉我们 “有错”, 却不一定能告诉我们 “错在哪里”。
发现错误,还不等于纠正错误
假设原来的数据满足偶校验,但是读取的时候有一个bit发生了翻转。
那么1的数量一定会改变奇偶性,奇偶校验就可以发现错误。
但是如果两个bit都发生了翻转呢?
比如原本是:10110010
其中的一个1变成了0,另外一个0变成了1,最后可能会得到:00110110。
虽然数据已经变了,但是1的数量还是可能是偶数。
这时简单的奇偶校验就会失败。
所以,一个校验规则能做的事是有限的。
如果想让ECC不仅能发现错误还能进一步定位到错误,则需要:增加更多的校验规则。
多个校验规则,开始具备“定位”能力
假设现在有4个bit: x₀,x₁,x₂,x₃
我们不再只设置一个校验条件,而是设置两个:
x₀⊕x₂=0;
x₁⊕x₂⊕x₃=0
也就是说:第一条规则检查的是 x₀和x₂;
而第二条规则是检查 x₁、x₂和x₃. 于是一个bit参与的校验组合并不完全一样。
假如说 x₂发生了一个错误,那么它同时参与了两条校验,都可能失败。
但是如果 x₀出错了呢?有可能就只是第一条校验失败而已。
换句话说:不同的错误位置,会对应着不同的校验结果。
只要把这些关系提前设计好了,主控就可以根据“哪些校验失败”,反过来判断“哪一位最可能发生错误”。
这是ECC从“发现错误”到“定位错误”的重要一步。
H矩阵:把所有校验关系放在一起
当校验方程越来越多,一个个写下来很快就会变得复杂。
于是我们可以把所有校验关系整理成一个矩阵,这就是校验矩阵H(Parity-Check Matrix)。
还是以上面的4个bit为例:
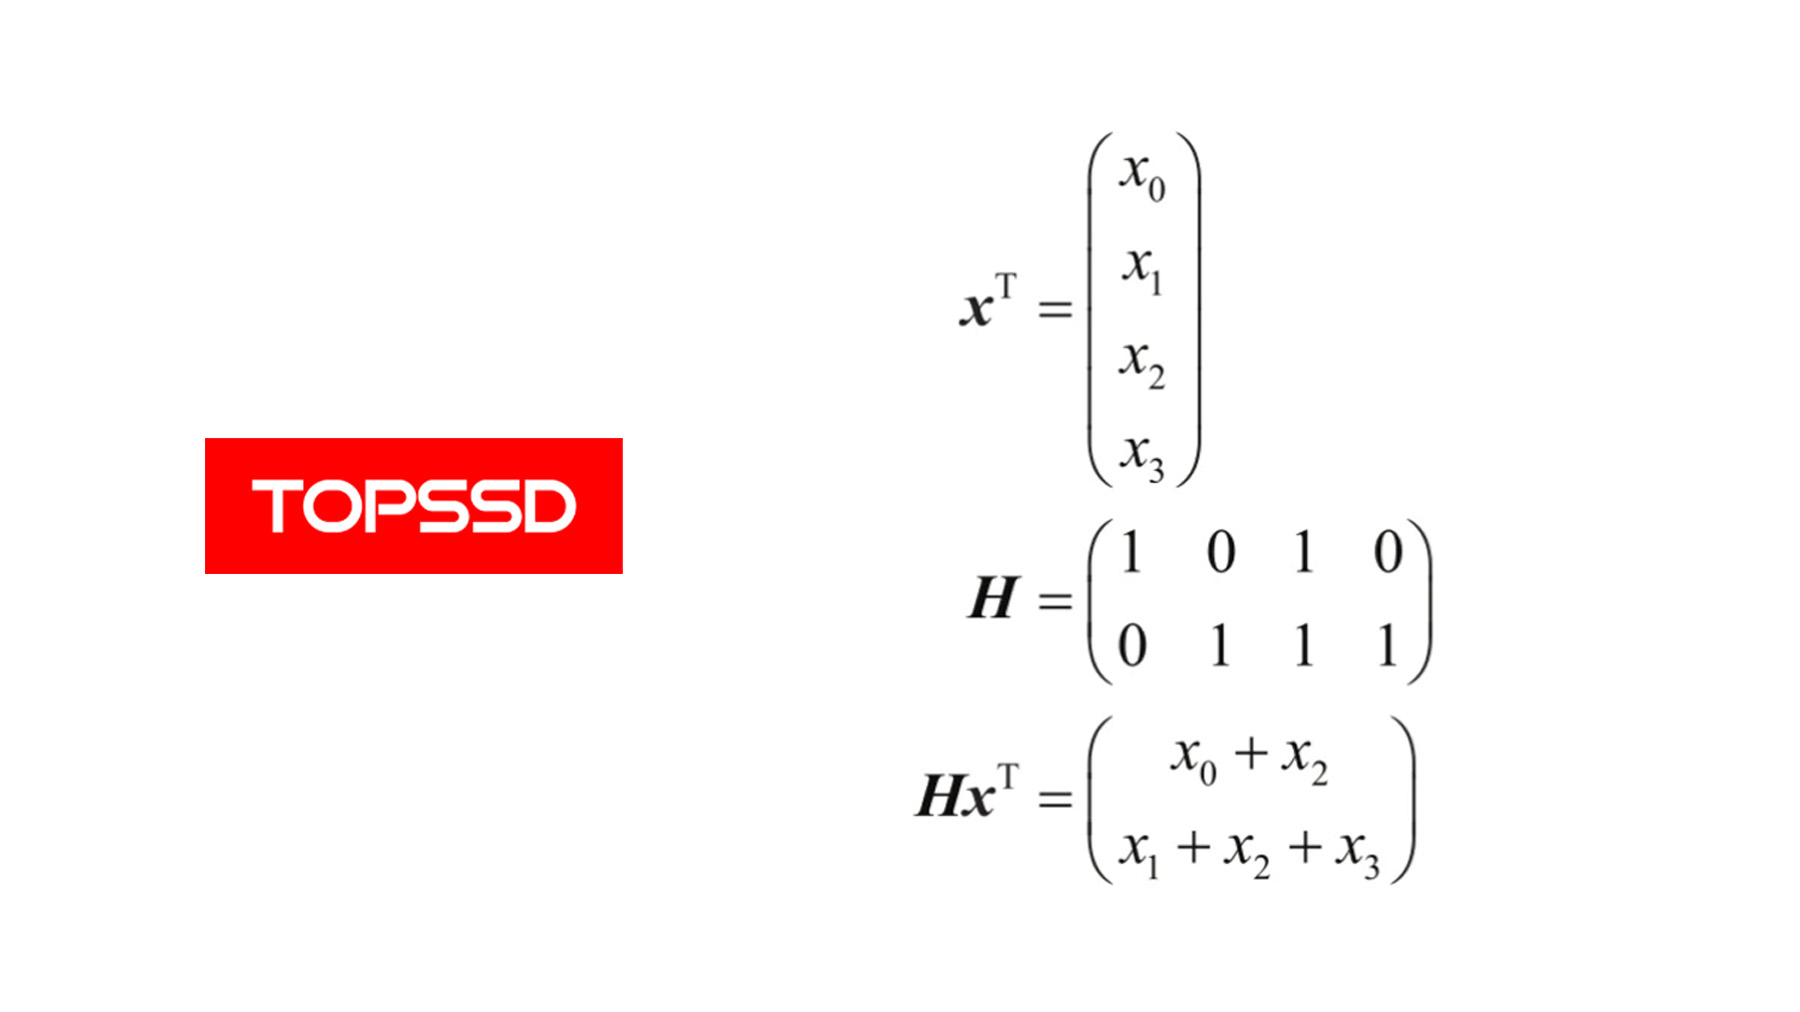
矩阵中的每一行,对应一条校验方程。
第一行的1出现在第0位和第2位,表示:x₀ ⊕ x₂ = 0
第二行的1出现在第1、2、3位,表示:x₁ ⊕ x₂ ⊕ x₃ = 0
因此,可以把H矩阵简单理解成一张“检查表”:
哪些bit需要接受哪条校验,由H来规定。
对于一个正确的码字,它必须同时满足H规定的所有校验关系,因此可以写成:
Hxᵀ = 0
而当结果不等于0时,就说明至少有一个校验关系被破坏,数据中可能存在错误。
这里的 Hxᵀ 也可以理解为一次完整的“体检结果”。
如果结果正常,说明所有校验都通过;如果某些位置出现异常,就意味着对应的校验关系没有满足。
错误为什么能够被“定位”?
看到这里,你可能会产生一个新的疑问:仅仅知道哪些校验失败,真的就能找到错误位置吗?
关键就在于:一个bit参与哪些校验,是提前设计好的。
因此,每个bit实际上都有一组属于自己的“校验指纹”。
当某个bit发生翻转时,它所参与的那些校验就会受到影响,最终形成一个特定的校验结果。
ECC解码器所做的事情,就是根据这些结果,判断:
哪个错误模式,与当前看到的校验结果最匹配?
当然,在实际的纠错码中,这种思想会被设计得更加复杂,但基本逻辑并没有变化:
通过冗余建立约束,再通过约束被破坏的方式反推错误。
为什么编码之间要尽量“拉开距离”?
除了校验关系,还有一个同样重要的概念值得补充:编码距离。
ECC并不是直接对任意数据进行判断,而是先把原始信息编码成特定的码字。
例如,两组合法码字分别是:000000 和 111000 。
比较这两个码字,可以发现前3个bit不同,因此它们的汉明距离为3。
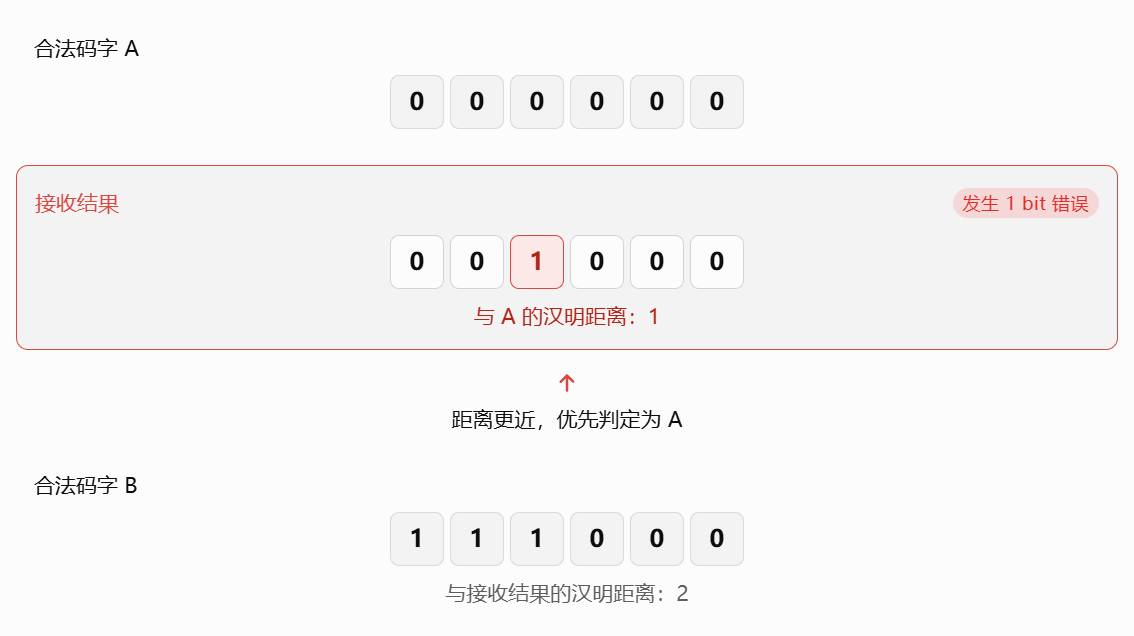
汉明距离,就是两个二进制序列之间不同bit的数量。
假设原本存储的是A,但读取时有一个bit发生了翻转,得到:001000
这时,读取结果既不等于A,也不等于B。应该选择哪一个?
我们可以分别计算它与两个合法码字的距离:
与A(000000)相比,只有1个bit不同,距离为1。
与B(111000)相比,有2个bit不同,距离为2。
显然,读取结果离A更近。因此,ECC可以优先将其判断为A,从而纠正这个bit错误。
这就是编码距离的意义:当读取结果不再是合法码字时,可以根据它与合法码字之间的距离,判断原始数据更可能是什么。
这样,即使读取过程中有少量bit发生错误,得到的结果仍然更可能靠近原来的码字,而不会轻易跑到另一个合法码字附近。
更一般地,对于最小汉明距离为 d 的纠错码:最多可以纠正 ⌊(d-1)/2⌋ 个bit错误。
因此,编码距离本质上是在衡量:不同合法编码之间有多难被混淆。距离越大,纠错空间通常也越大。
从奇偶校验到纠错码
到这里,ECC的基本逻辑已经逐渐完整了:
最开始,我们只增加一个简单的奇偶校验,可以发现部分错误。
随后,我们增加更多校验方程,让不同的bit参与不同的检查,从而获得定位错误的能力。
再进一步,通过合理设计不同合法码字之间的距离,提高系统抵抗错误的能力。
而把这些校验关系系统地组织起来,就得到了更完整的线性纠错码。
其中:H矩阵负责定义校验关系。
而在编码时,还需要另一套矩阵来完成原始数据到编码数据的转换,这就是生成矩阵G(Generator Matrix)。
可以把两者简单理解成:G负责“怎么加冗余”;H负责“怎么检查”。
至此,我们已经知道ECC为什么能够纠错,也知道了它的基本工具是怎样建立起来的。
但随着NAND Flash不断向更高存储密度发展,SSD面对的错误也越来越复杂。
如果只是不断增加校验规则,计算量也会随之增长。
有没有一种纠错码,既能提供强大的纠错能力,又能让这些庞大的校验关系保持较高的计算效率?这正是下一篇要登场的主角:LDPC。


