
SSD为什么需要ECC?
SSD为什么需要ECC?
我们已经知道,NAND Flash并不是绝对可靠的存储介质,在数据写入之后,随着时间的推移和擦写次数的变化,还有工作环境等影响因素,导致最终读出的结果可能会跟最初写入的数据不一致。
那么问题来了:数据真的读错了,SSD主控怎么知道?又怎么把它纠回来呢?
答案,就是ECC。
ECC究竟是什么?
ECC全称是Error Correcting Code,也就是纠错码。
从名字就能看出,它的任务和“错误”有关。但是要先说明一下,ECC不能阻止NAND产生错误。
它真正做的工作是在数据写入的时候,加上一些额外的信息,使得数据即便在之后的读取中发生了某种程度上的变化,主控依然可以凭借这些额外的信息,来判断出原来的那部分数据到底是什么样的。
而这个额外的信息就叫做冗余信息。
我们也可以简单的把这个过程想象成这样:
原始数据 -> 编码并加入冗余 -> 写入NAND -> 读取 -> ECC解码 -> 恢复原始数据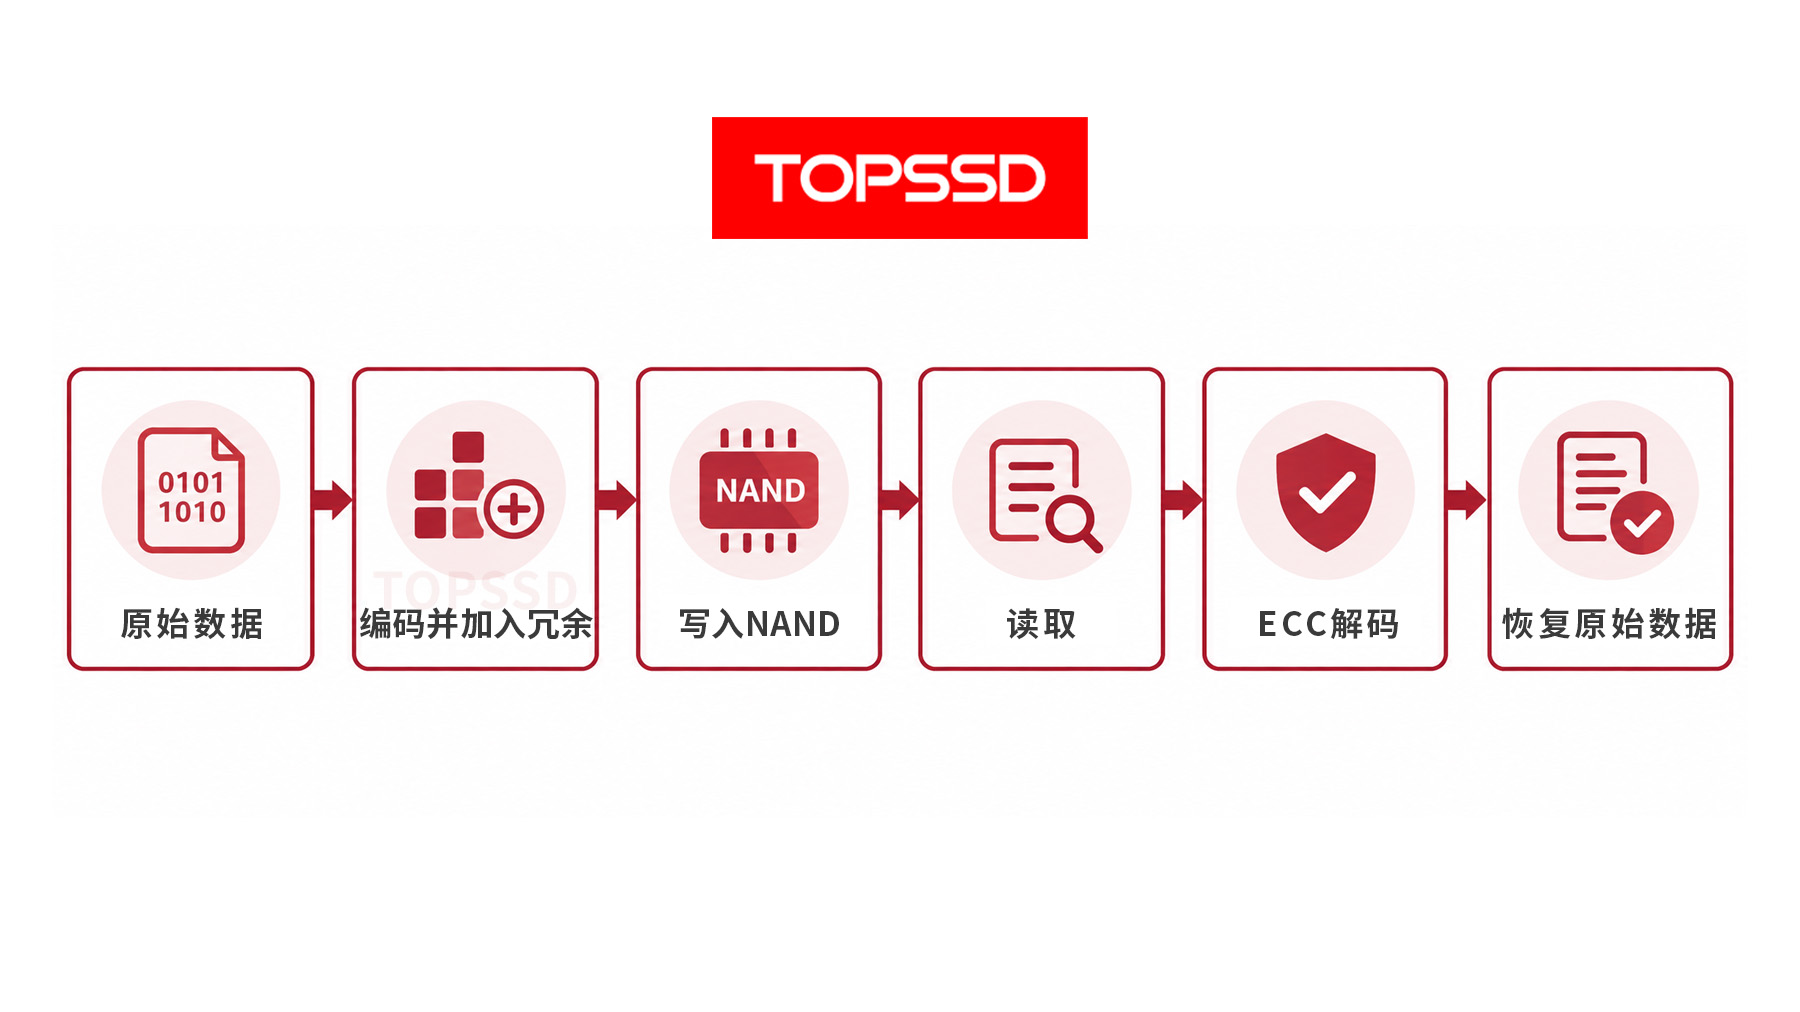
所以ECC解决的问题不是“让数据永远不出错”。而是:
就算数据出了点问题,也要尽可能地把它恢复回来。
NAND可以看成一条“有噪声的信道”
为了更好的理解ECC,我们还可以借用通信系统中的一个概念:信道。
在通信的过程中,数据从发送端传到接收端,中间的信道,并不一定是可靠的,噪声可能会导致接收到的信息发生改变。SSD也可以做类似地抽象:
数据经过编码后写入NAND,NAND负责保存这些信息;然后主控再读取,得到的是可能受到了一定的干扰的结果。
于是:原始数据 -> 编码数据 -> NAND信道 -> 读取数据 -> ECC解码
这里的“NAND信道”,我们可以理解成是数据从写入到读取过程中的存储环境。
它也让我们得以换一个角度去看待SSD:存储,本质也是一次信息传递。
只不过普通的通信是在不同的设备间传递信息,而SSD则是存储介质中保存信息而已。
为什么增加冗余,就能够纠错?
我们现在有一段二进制数据:10011101
如果只保存这8个比特,当NAND出现错误,那么未来可能会读出来变成:10111001
究竟哪一个位出了问题?我们其实是不知道的。
但是如果我们在写的时候,加上了一些经过计算得到的冗余信息,那情况就不一样了。
这些冗余不是简单的“再存一份相同的”数据,它们跟原来的数据有某种关系。
然后读出来的时候,主控可以去重新检查这些关系。
如果还是符合的话,那就说明数据大概率是没有出错;
如果不符,则说明可能其中有错误,而且通过不同的校验结果,还能判断错误发生在哪里、并试图恢复正确的数据。
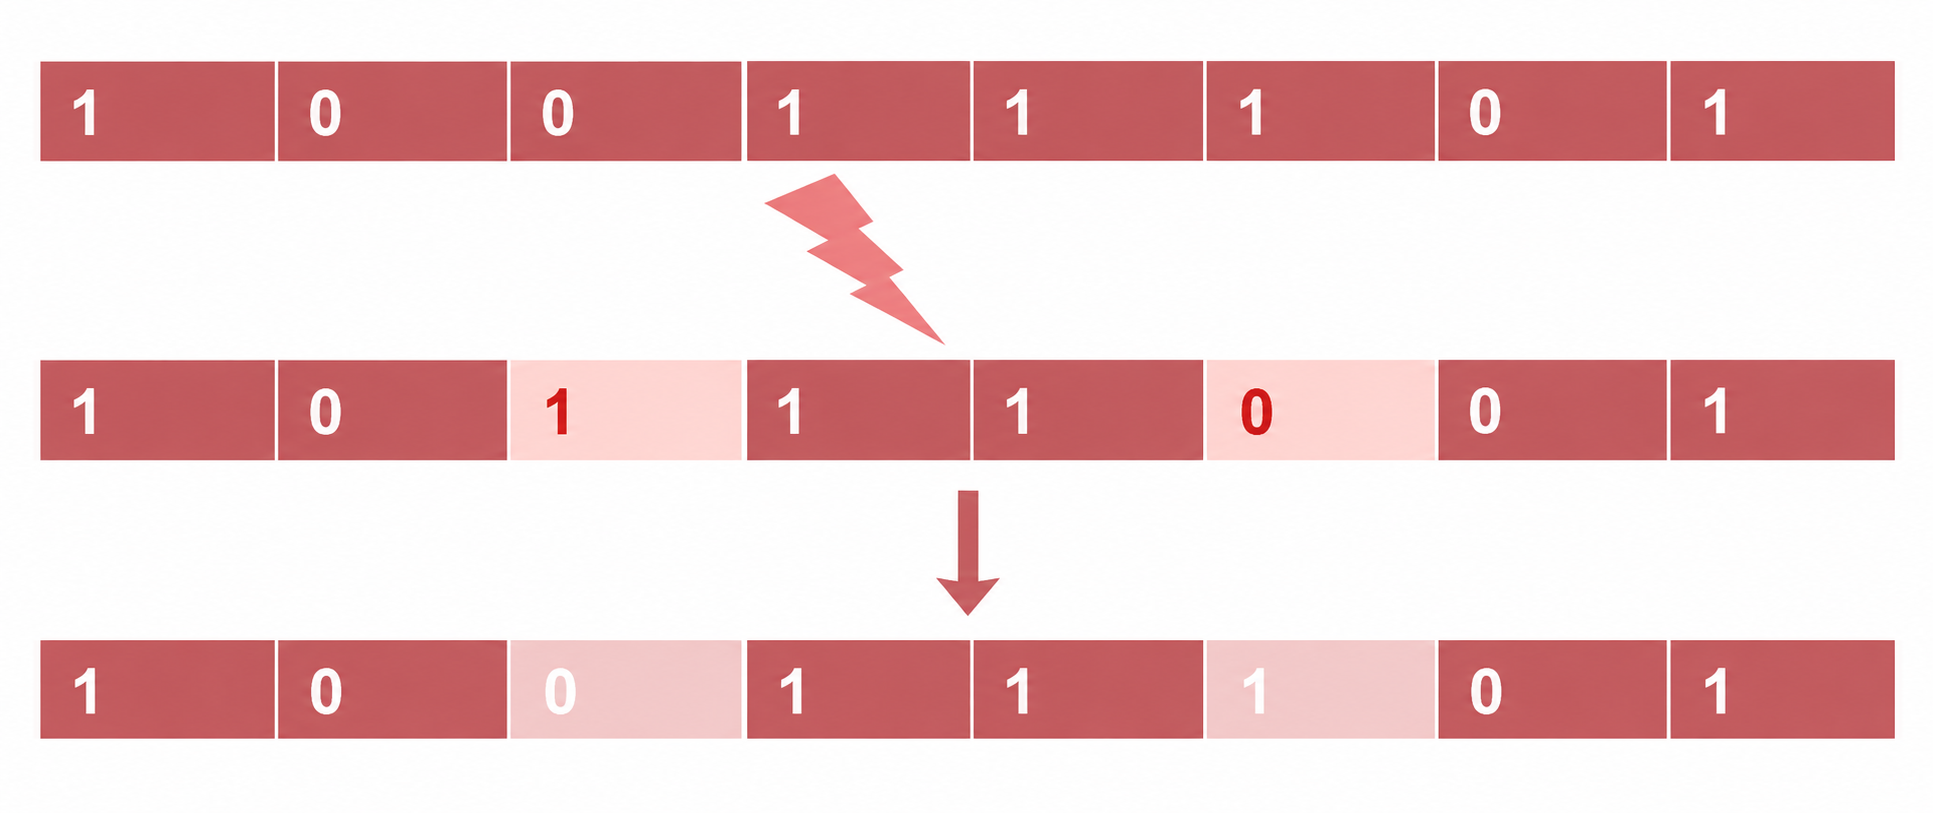
所以,ECC真正有价值的是:这些额外的比特给原来的数据建立了一个可以被检查和利用的约束。
这也是后面理解各种纠错码的关键。
冗余越多越好吗?
既然冗余可以帮助纠错,那是不是加入的冗余越多,数据就越可靠呢?
通常来说,更多的冗余就意味着更强的保护空间,但是代价会随着冗余增多而增大。
工程上常用的码率(Code Rate),用来描述有效信息和编码后的总信息的关系:
Code Rate = 信息比特数 / 编码后总比特数
比如本来的原始数据有100个比特,在加入了冗余之后变成了120个比特,那么它的码率就应该是这样的:
100 ÷ 120 = 5/6
也就是这120个比特中有100个是有效的信息,剩下的20个负责保护的作用。
所以一般也可以这么理解:码率越高,冗余越少;码率越低,冗余越多。
但对于一块SSD而言,它是一个需要同时考虑容量、性能、功耗以及可靠性的系统,并不是说冗余越多越好。
所以对于SSD主控的设计者们来说,真正的难点就在于:用多少冗余,建立什么样的规则,才能够在可接受的成本下拥有足够的纠错能力?
从“增加冗余”到“建立规则”
到这里,我们已经知道了ECC最基本的思想:数据可能会发生错误,在写的时候提前加一些冗余进去;这些冗余和原始的数据有某种约束关系,然后在读的时候再利用这种约束来检查数据并尽可能地把错误给修复回来。
但我们目前只解决了“方向”这一个问题。这个约束到底该怎么设计?
这就得从二进制最基本的校验方式——奇偶校验开始讲起了。它会告诉我们要如何使用最基础的校验规则,去发现一个数据块是否发生了错误,该如何“发现错误”跟“纠正错误”。如果有一个校验规则不够用的话,又该怎么办?
下一篇我们就从最简单的奇偶校验开始,看ECC是如何一步一步得到“找出错误”的能力。


